Relatório de Desempenho — Prova Teórica 1 (GPS 2026-2)
Estatísticas Gerais
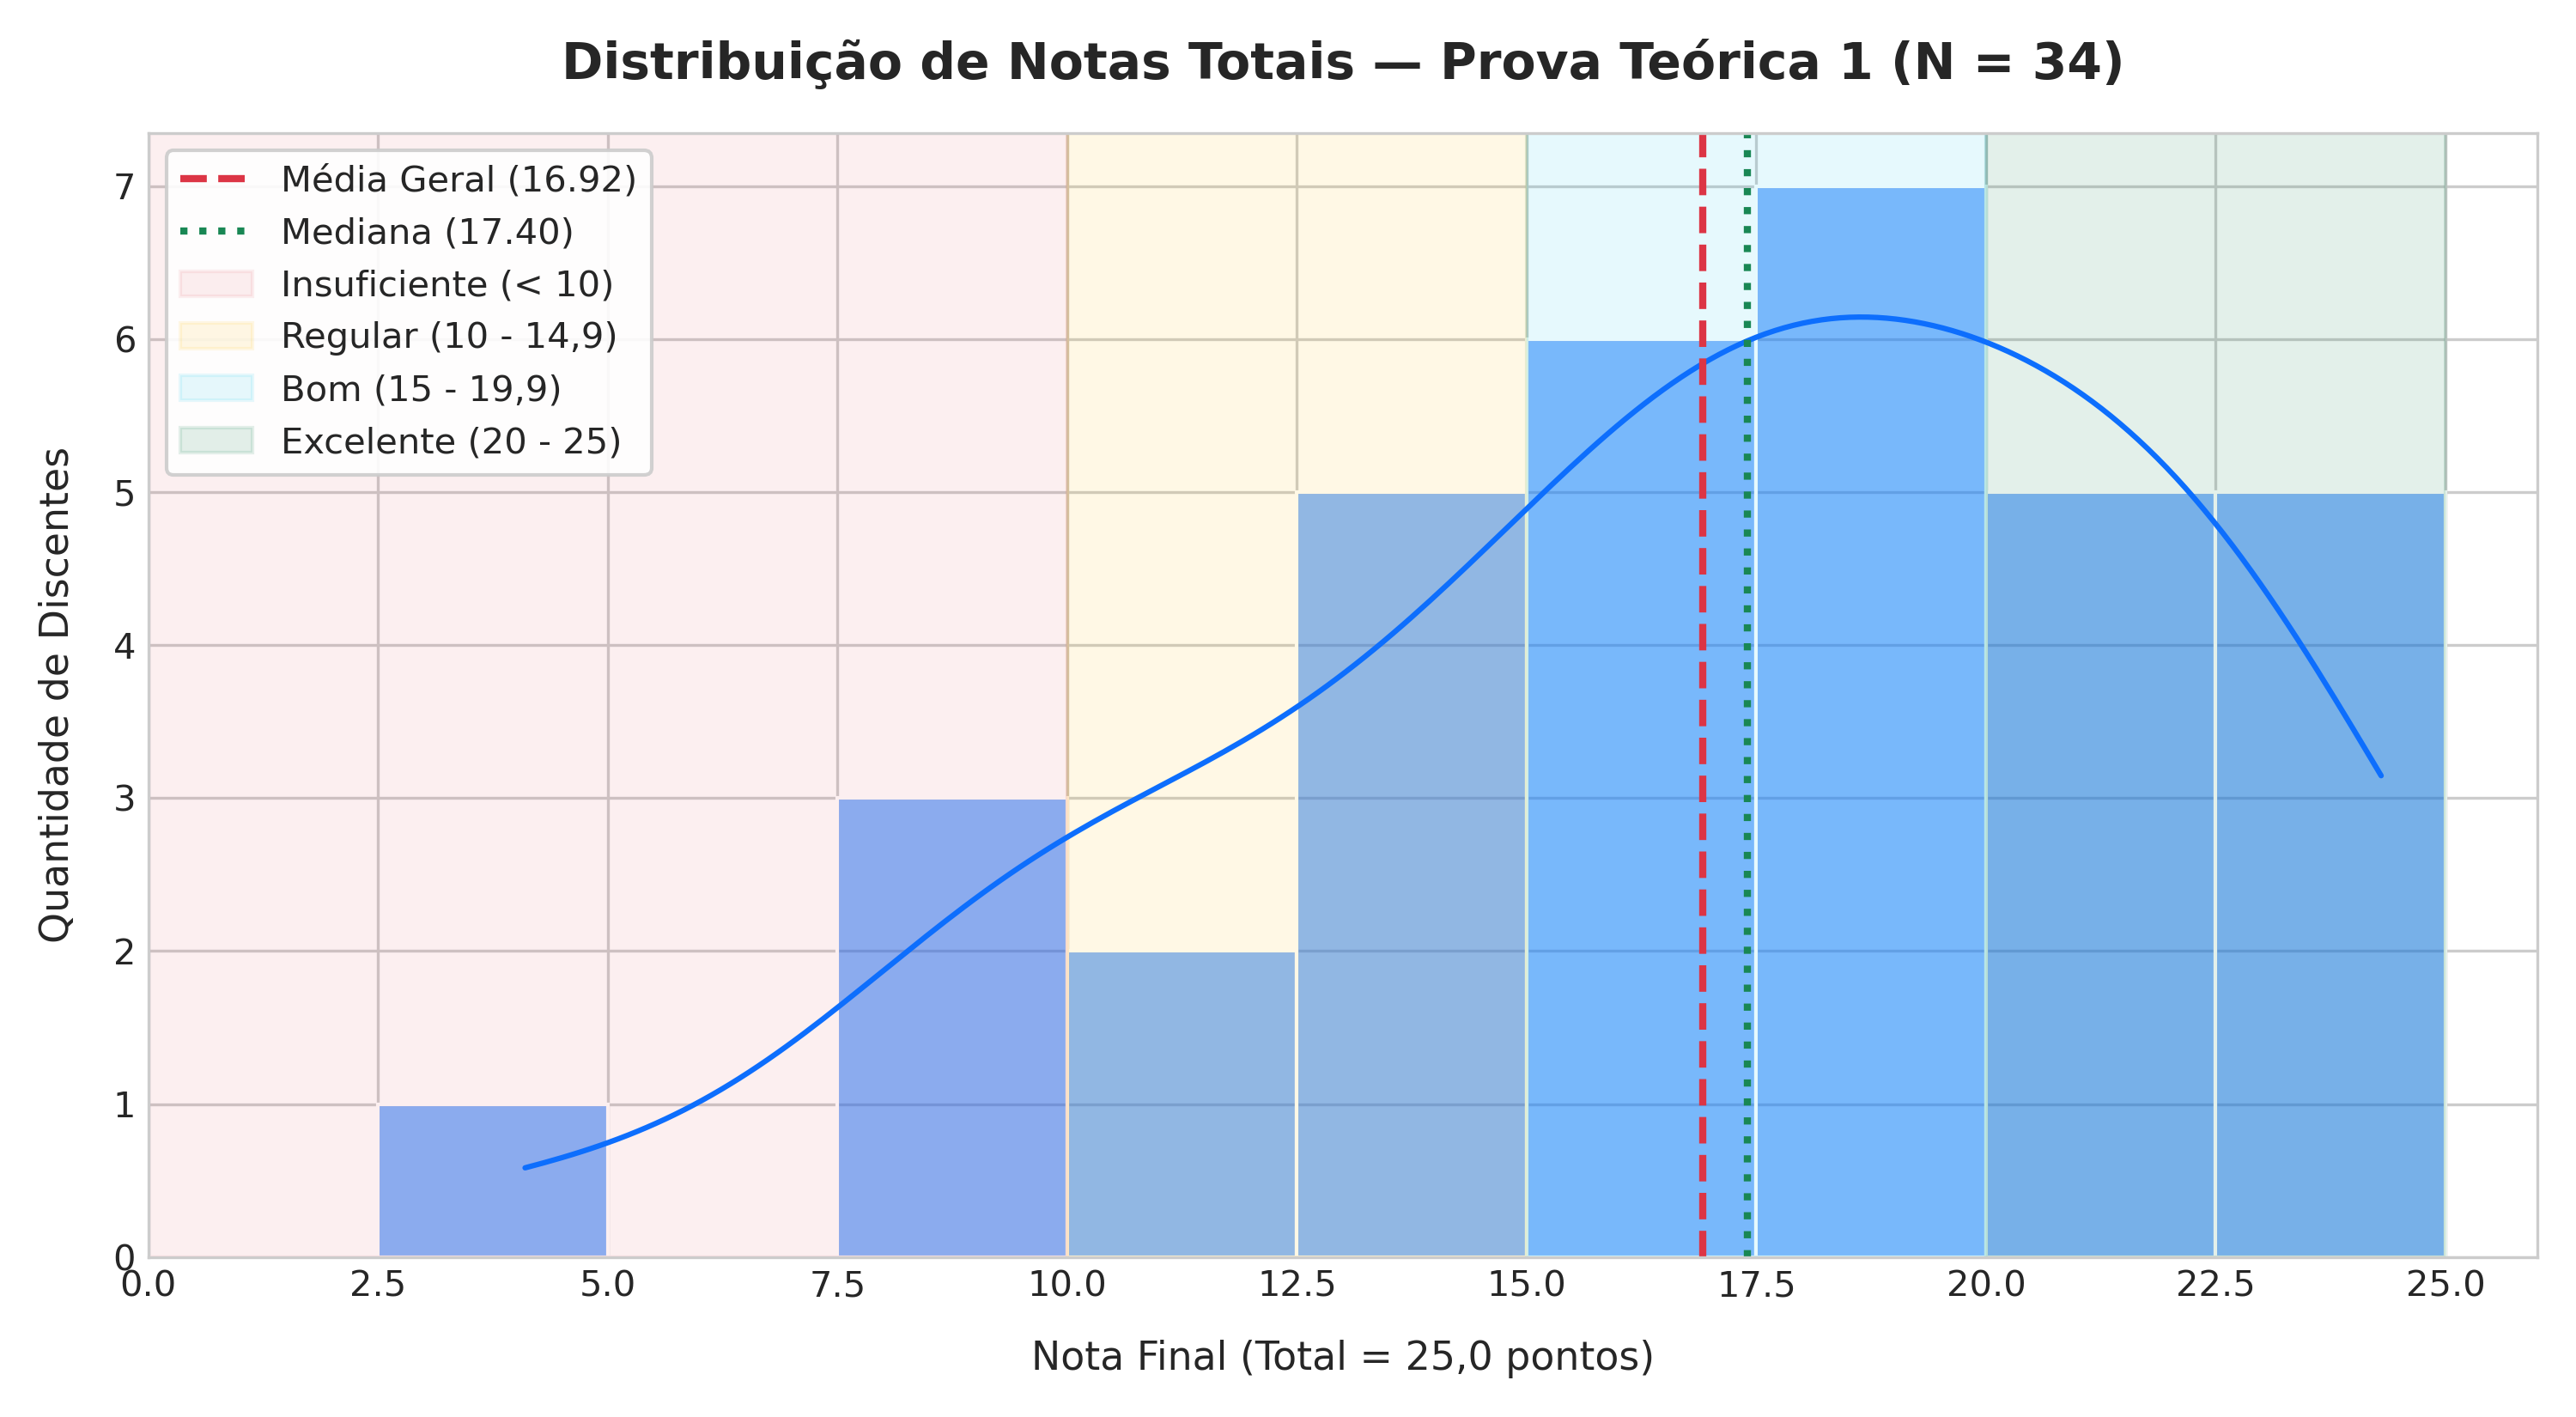
- Alunos avaliados: 34
- Nota máxima possível: 25,0
- Nota mínima obtida: 4,1
- Nota máxima obtida: 24,3
- Média geral: 17,0
- Mediana: 17,7
Distribuição por faixa
| Faixa | Alunos | % |
|---|---|---|
| 20,0–25,0 (excelente) | 10 | 29% |
| 15,0–19,9 (bom) | 13 | 38% |
| 10,0–14,9 (regular) | 7 | 21% |
| 0,0–9,9 (insuficiente) | 4 | 12% |
Média por questão
| Questão | Tema | Média | Máx | Aproveitamento |
|---|---|---|---|---|
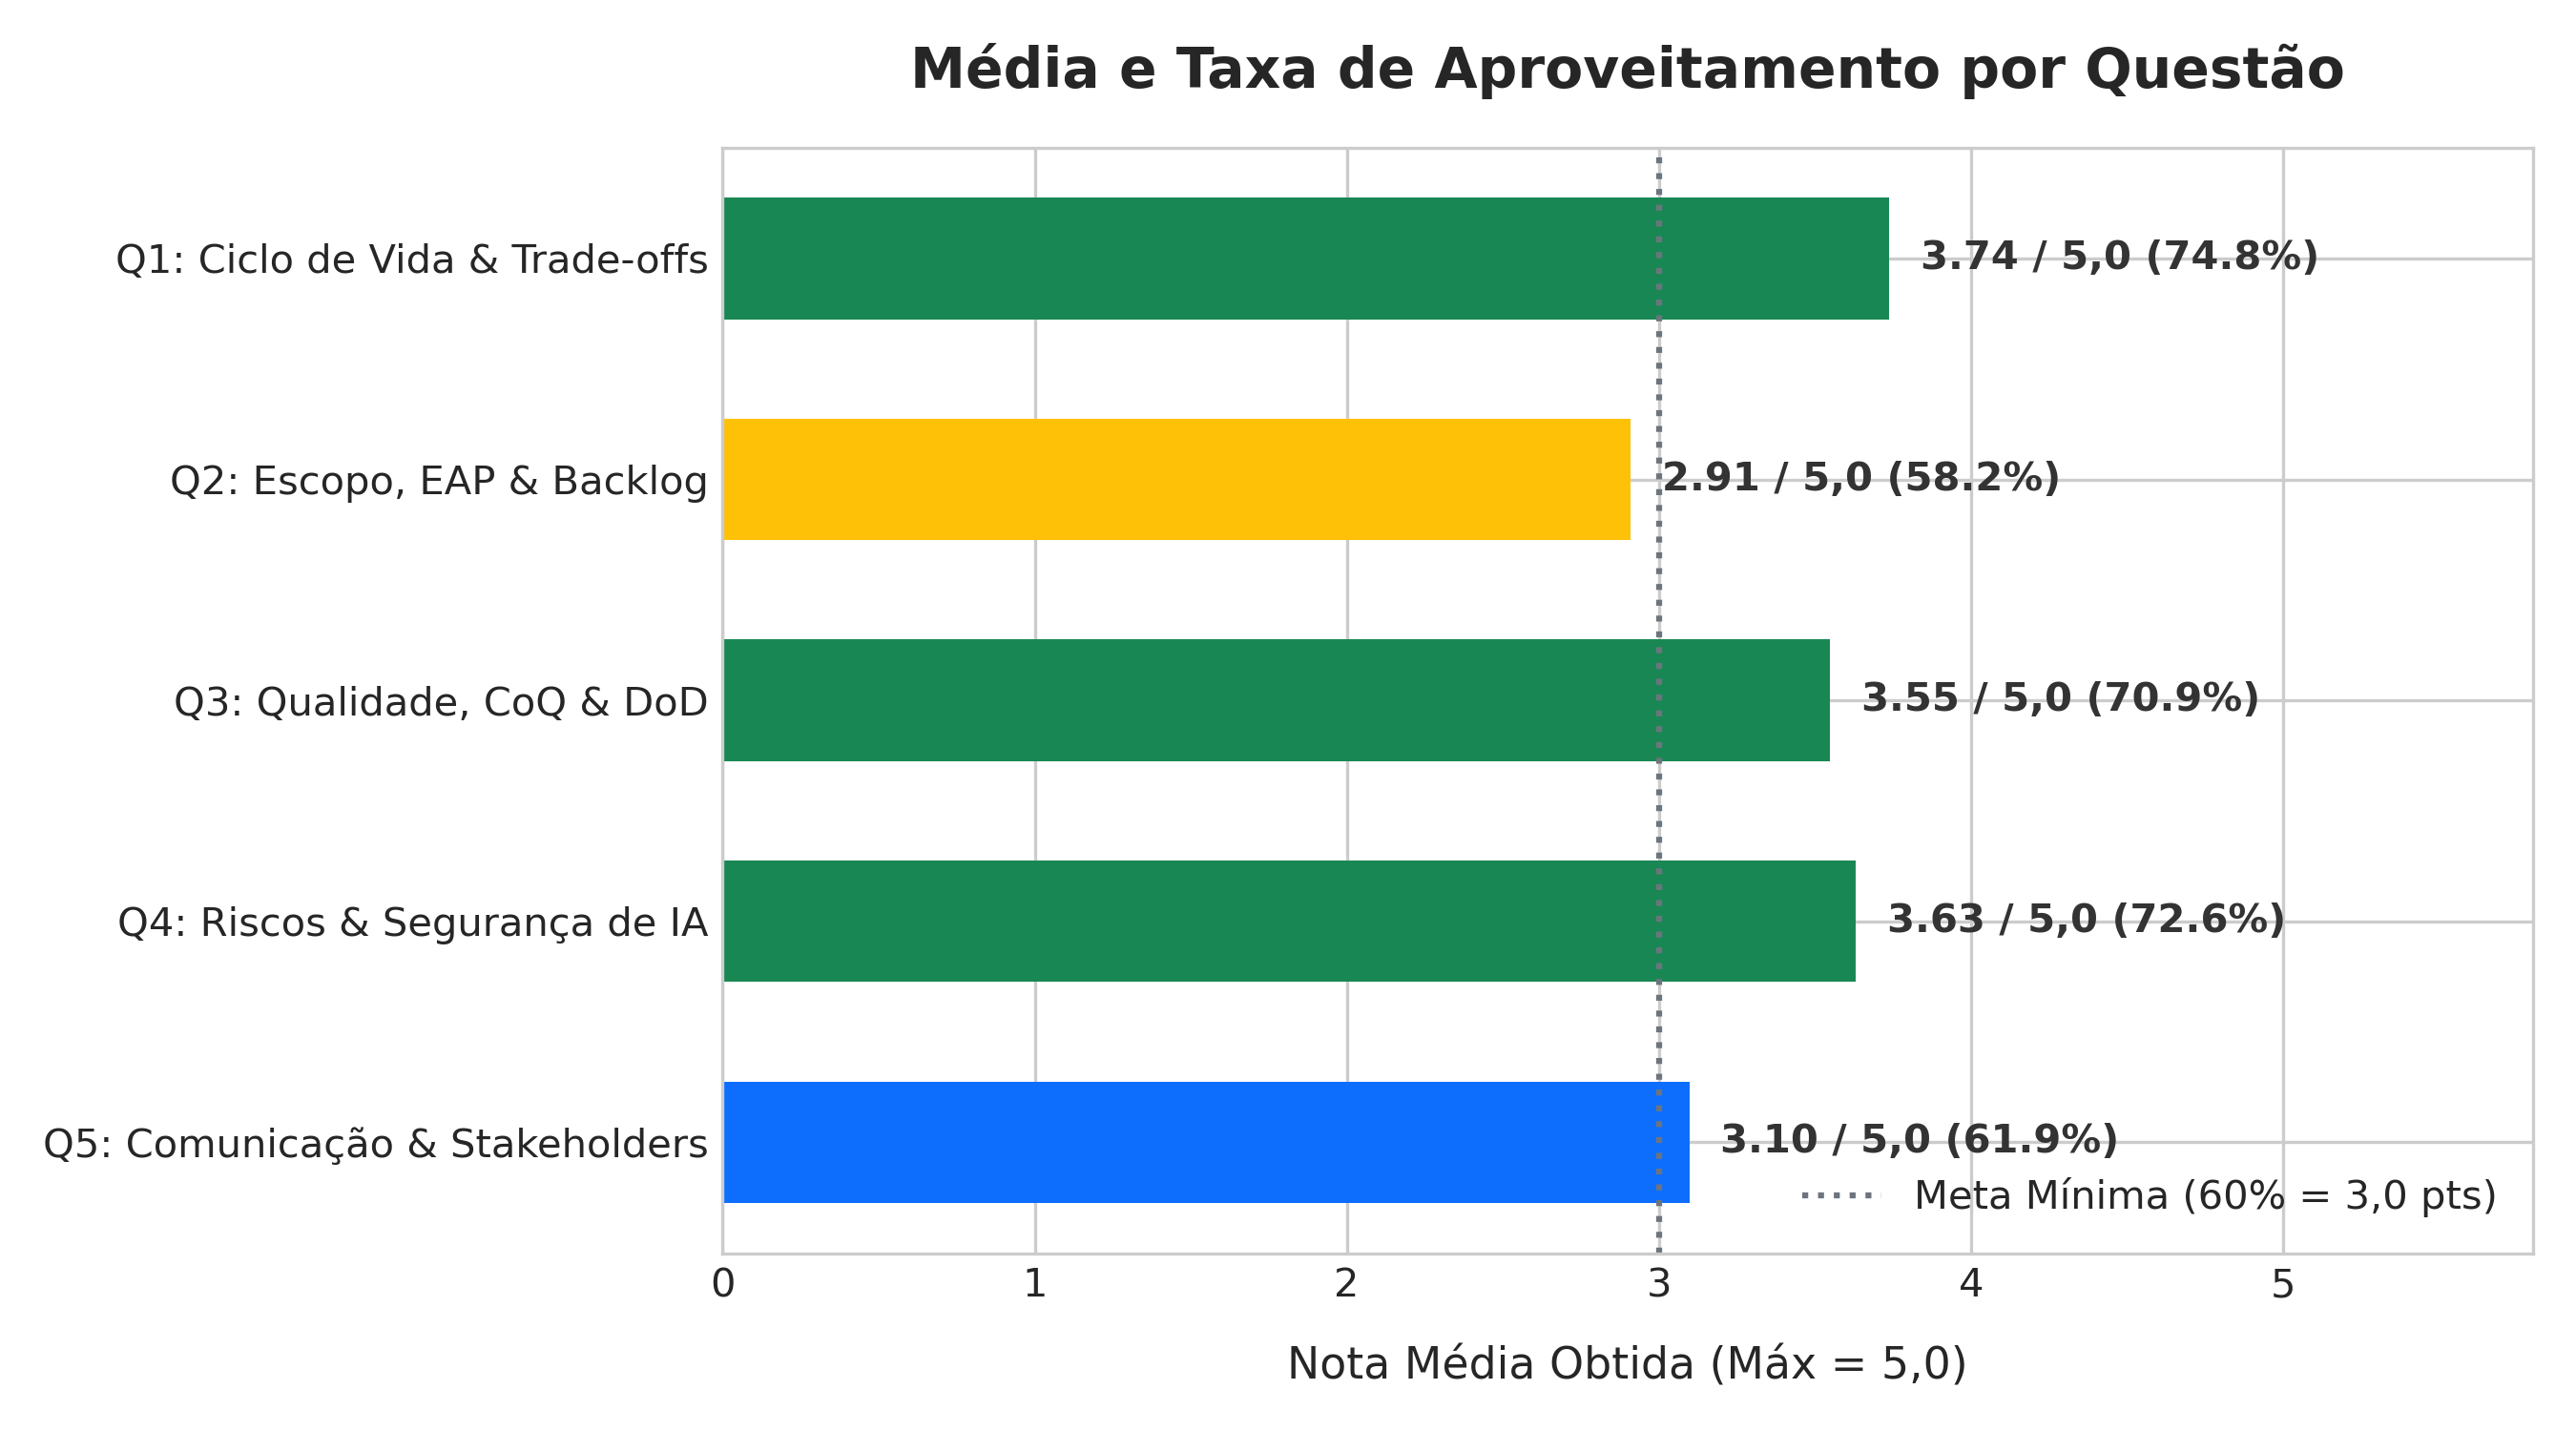
| Q1 | Projeto, Ciclo de Vida e Trade-offs | 3,7 | 5,0 | 74% |
| Q2 | Escopo, EAP e Backlog | 2,9 | 5,0 | 58% |
| Q3 | Qualidade, CoQ e DoD | 3,4 | 5,0 | 68% |
| Q4 | Riscos, Segurança de IA e Documentação | 3,5 | 5,0 | 70% |
| Q5 | Comunicação, Stakeholders e Conflitos | 3,4 | 5,0 | 68% |
Acertos e Erros Mais Comuns por Questão
Q1 — Projeto, Ciclo de Vida e Trade-offs (média 3,5/5,0)
Acertos frequentes:
- A maioria identificou o Professor Agente como projeto (temporário, produto único, progressivo), citando Sprints, prazo do semestre e descoberta progressiva da complexidade como evidências. Os melhores usaram os três critérios do Capítulo 1 com precisão: temporalidade, unicidade e elaboração progressiva.
- Nas alternativas de trade-off, a resposta mais comum e correta foi reduzir escopo (entregar MVP, priorizar funcionalidades essenciais) ou aumentar custo (plano pago da API, mais horas da equipe). Vários também propuseram negociar prazo.
- Na classificação do ciclo de vida, a turma dividiu-se entre ágil e híbrido, ambos aceitos com justificativa adequada no gabarito.
Erros recorrentes:
- Confundir projeto com operação. Cerca de 3 alunos classificaram o Professor Agente como operação, argumentando que “tem custos contínuos” ou “precisa de manutenção depois de pronto”. Isso indica que o conceito de temporalidade (início, meio, fim) ainda não está consolidado para todos.
- Não rejeitar explicitamente o sacrifício de qualidade. Alguns alunos analisaram o impacto de reduzir os testes sem propor alternativas que preservassem qualidade — o enunciado pedia alternativas diferentes de sacrificar qualidade.
- Análise rasa do ciclo de vida. Alguns apenas escreveram “ágil” ou “híbrido” sem justificar com as evidências do texto (Sprints, 15 aulas, descoberta de complexidade).
- Vocabulário impreciso: respostas como “diminuir a qualidade” ou “trocar qualidade por tempo” revelam que o trade-off do Triângulo de Ferro (com qualidade como critério negociado, não sacrificado) precisa de reforço.
Q2 — Escopo, EAP e Backlog (média 2,7/5,0 — a mais baixa)
Acertos frequentes:
- A maioria desenhou uma EAP correta em dois níveis, com substantivos (Autenticação, Chat, Integração LLM, Dashboard) e identificou ao menos 2–3 pacotes de trabalho.
- Nas Issues, a estrutura título + descrição + estimativa apareceu na maior parte das provas.
- Alunos de destaque (Davi, Pedro, Gabriel Pinheiro) aplicaram PERT com estimativa de 3 pontos
(O + 4M + P)/6— uso sofisticado que não era exigido, mas demonstra domínio. - A maioria entendeu que Milestones não substituem Sprints; são complementares.
Erros recorrentes:
- EAP com verbos em vez de substantivos (ex.: “Fazer autenticação”, “Desenvolver chat”). EAP é orientada a entregas, não a atividades.
- Hierarquia confusa: alunos colocaram atividades como “Decidir API” ou “Testar comandos” como pacotes de entrega, quando são tarefas dentro de um pacote.
- Regra dos 100% não explicada. Muitos desenharam a EAP mas não explicaram por que a regra dos 100% é importante (todo o escopo está contido; nada fora, nada omitido).
- Estimativa sem justificativa relativa. Deram números (horas, Story Points) mas não compararam por que uma Issue é mais complexa que a outra.
- Confusão Milestone = Sprint. Cerca de 4 alunos trataram Milestone e Sprint como sinônimos ou afirmaram que Milestone “é a Sprint no GitLab”. O gabarito cobra a distinção: Milestone é marco temporal, Sprint é iteração Scrum.
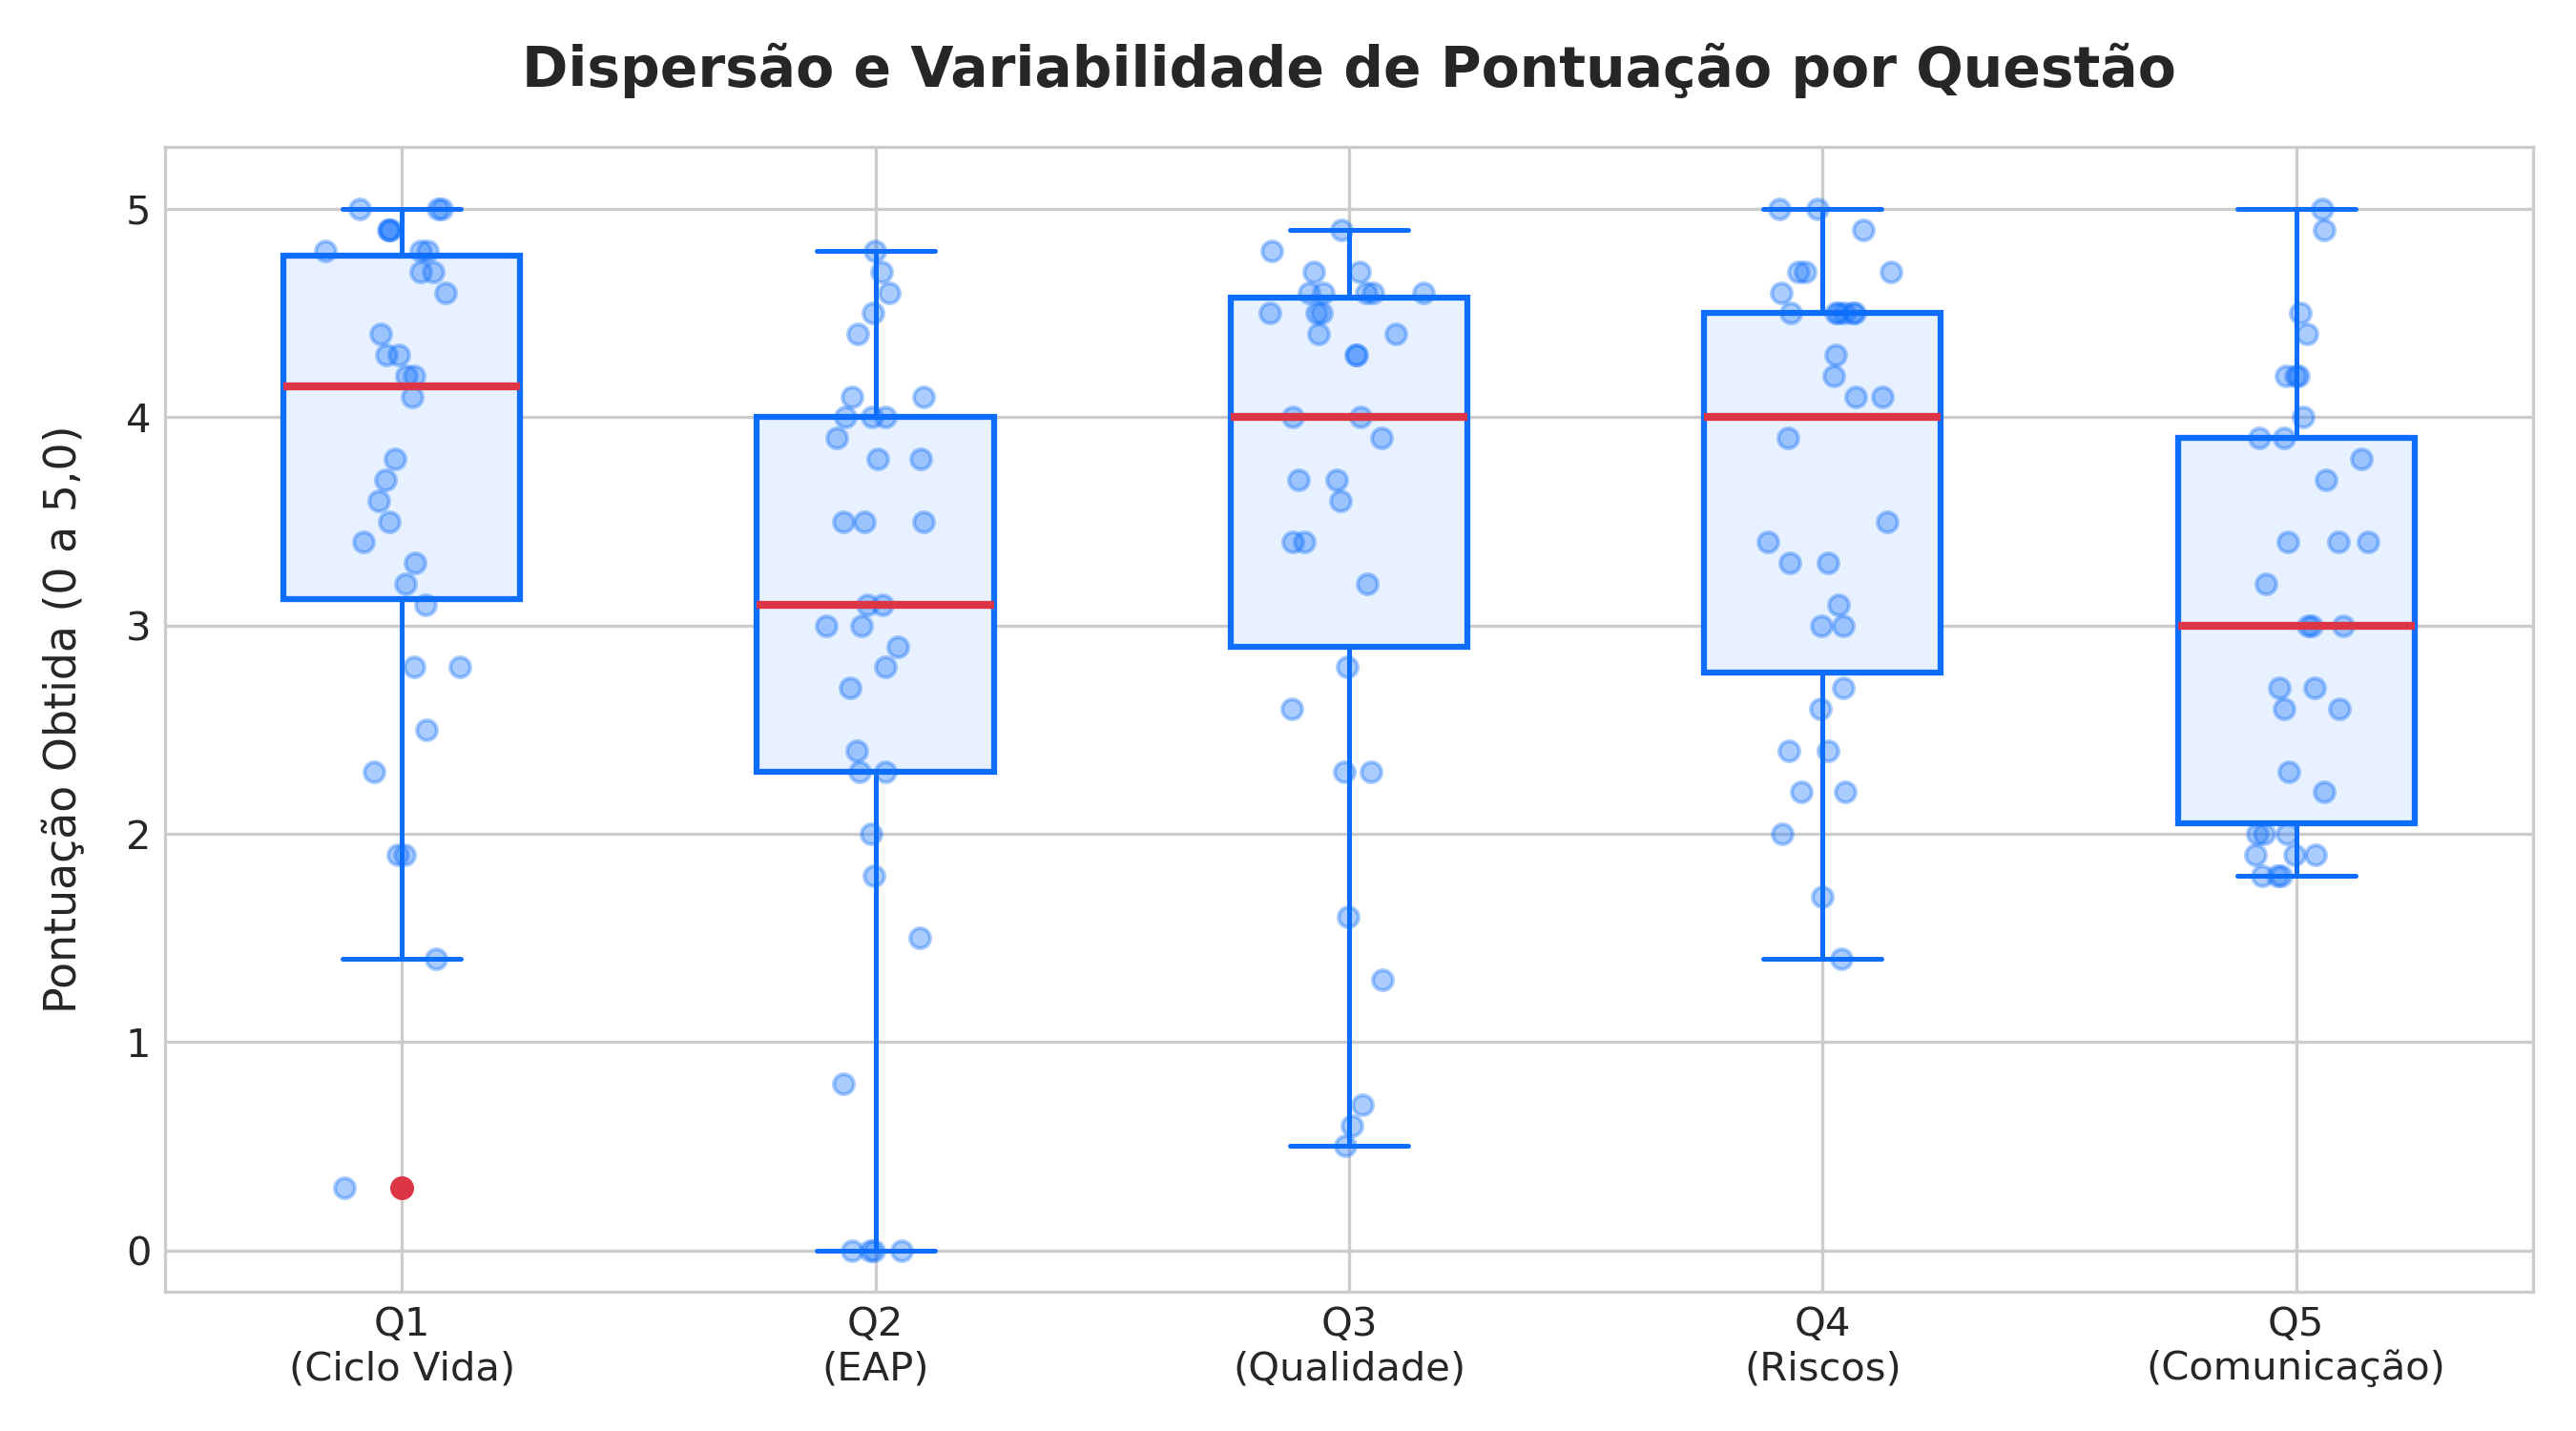
- Questão deixada em branco parcial ou totalmente por 3 alunos. É a questão com mais itens não respondidos da prova inteira.
Q3 — Qualidade, CoQ e DoD (média 3,4/5,0)
Acertos frequentes:
- DoD foi bem compreendido como “lista de critérios que precisam ser atendidos para considerar algo pronto”. A maioria concluiu que sem testes de segurança o chat não está pronto.
- A classificação CoQ (prevenção, avaliação, falha interna, falha externa) teve bom índice de acerto, especialmente nos itens (a), (b) e (c). O item (d) gerou mais dúvida.
- A maioria identificou falha externa como o custo mais alto, com justificativas como “afeta o usuário final”, “dano à reputação” e “correção emergencial”.
Erros recorrentes:
- Inversão entre prevenção e avaliação. Cerca de 5 alunos classificaram “revisão de código” como avaliação e “testes automatizados” como prevenção. Revisão de código é prevenção (encontra defeitos antes de existirem); testes são avaliação (verificam qualidade do que já foi construído).
- Inversão entre falha interna e externa. “Bug de segurança encontrado em produção por um aluno” é falha externa (já chegou ao usuário), mas alguns classificaram como interna. “Falha no deploy que impede o chat de carregar” é falha interna (detectada antes de chegar ao usuário final, se o deploy falhou), mas vários marcaram como externa.
- Heurística 1:10:100 tratada como lei. Cerca de 6 alunos afirmaram categoricamente que “o custo é sempre 100x maior” sem mencionar que é uma heurística com limites, especialmente em software com IA onde alucinações e comportamento não determinístico tornam a proporção não linear.
- 3.3 em branco para 2 alunos. O subitem mais conceitual e que exigia pensamento crítico (limites da heurística em IA) foi o mais deixado em branco na Q3.
Q4 — Riscos, Segurança de IA e Documentação (média 3,5/5,0)
Acertos frequentes:
- A distinção risco versus problema foi bem compreendida: antes do commit, era risco; após o vazamento, materializou-se em problema. A maioria pontuou aqui.
- A matriz P×I foi bem preenchida, com a maioria posicionando “vazamento de chave” como probabilidade média/alta e impacto alto.
- Nas ações imediatas, revogar a chave foi citado por quase todos; investigar logs e notificar o responsável apareceram com frequência.
- Prompt injection foi o risco de IA mais modelado, com alunos descrevendo mitigação via filtro de entrada e system prompt robusto.
Erros recorrentes:
- Ações preventivas genéricas. Vários sugeriram apenas “não commitar chaves” ou “ter cuidado” em vez de medidas concretas: detecção de segredos no pipeline (GitLab Secret Detection, gitleaks), variáveis de ambiente, cofre de segredos,
.gitignorecom.env. - Defesa em profundidade ausente. Cerca de 8 alunos propuseram apenas uma camada de proteção (ex.: “usar .env”) sem combinar com detecção no pipeline, bloqueio de merge e rotação programada.
- Modelagem de risco incompleta. No subitem 4.3 (risco de entrada com causa, probabilidade, impacto, mitigação e contingência), muitos modelaram apenas 2 ou 3 dos 5 elementos pedidos. Contingência foi o item mais omitido.
- Confusão entre ADR, runbook e README. Alguns recomendaram README para registrar decisões de segurança; README é para onboarding, ADR é para decisões arquiteturais. O gabarito espera ADR.
- Risco de saída (alucinação) com mitigação superficial. Poucos citaram few-shot prompting, testes de regressão automatizados ou temperatura baixa como mitigação; a maioria disse apenas “validar a resposta”.
Q5 — Comunicação, Stakeholders e Conflitos (média 2,9/5,0)
Acertos frequentes:
- O cálculo de canais de comunicação foi o item com maior acerto da prova: praticamente toda a turma calculou
C = 5×4/2 = 10. - A matriz Poder × Interesse foi bem preenchida, com a maioria posicionando Professor e Equipe como “Gerenciar de perto”, Alunos como “Manter informado” e Provedor de API como “Monitorar”.
- A maioria escolheu Colaborar como abordagem de Thomas-Kilmann para o conflito, o que é a resposta esperada.
Erros recorrentes:
- Fórmula citada sem explicação do modelo de pares. Muitos calcularam 10 mas não explicaram que a fórmula
n(n-1)/2conta pares bidirecionais de comunicação. Alguns disseram “cada um fala com todos”, o que serian(n-1)(10×9 seria 90, errado). - Síncrono vs. assíncrono não analisado. O subitem 5.1 pedia explicitamente a análise de canais síncronos e assíncronos, mas cerca de 10 alunos apenas calcularam a fórmula e não desenvolveram essa parte.
- Premissas dos stakeholders não declaradas. O subitem 5.2 pedia premissas explícitas para os dois stakeholders mais críticos; vários posicionaram os stakeholders na matriz sem declarar as premissas, perdendo pontuação.
- Estratégia de comunicação genérica. “Reunião semanal” ou “manter informado” sem especificar frequência, canal e conteúdo. O gabarito espera algo como: “Sprint Review a cada 2 semanas, demonstração do incremento, ata de feedback”.
- Thomas-Kilmann com abordagens inadequadas mal justificadas. Cerca de 5 alunos escolheram a abordagem correta (Colaborar) mas não souberam explicar por que Forçar, Evitar ou Conceder seriam inadequadas neste caso. Alguns confundiram Forçar com “decidir rápido” como algo positivo.
- 5.3 deixado em branco por 2 alunos. É o subitem de 2,0 pontos mais deixado sem resposta, junto com 4.3.
Curiosidades e Observações Qualitativas
Destaques positivos
- Uso de PERT nas estimativas. Dois alunos (Pedro Cláudio e Gabriel Pinheiro) aplicaram a fórmula de estimativa de três pontos
(O + 4M + P)/6nas Issues da Q2, demonstrando domínio de técnica avançada de gestão de projetos que não era exigida na prova. - Respostas com exemplos do trabalho prático. Alunos que vincularam as respostas ao seu próprio projeto do Professor Agente (citando Telegram, OpenAI, GitLab CI) produziram respostas mais contextualizadas e completas, especialmente nas questões 2, 4 e 5.
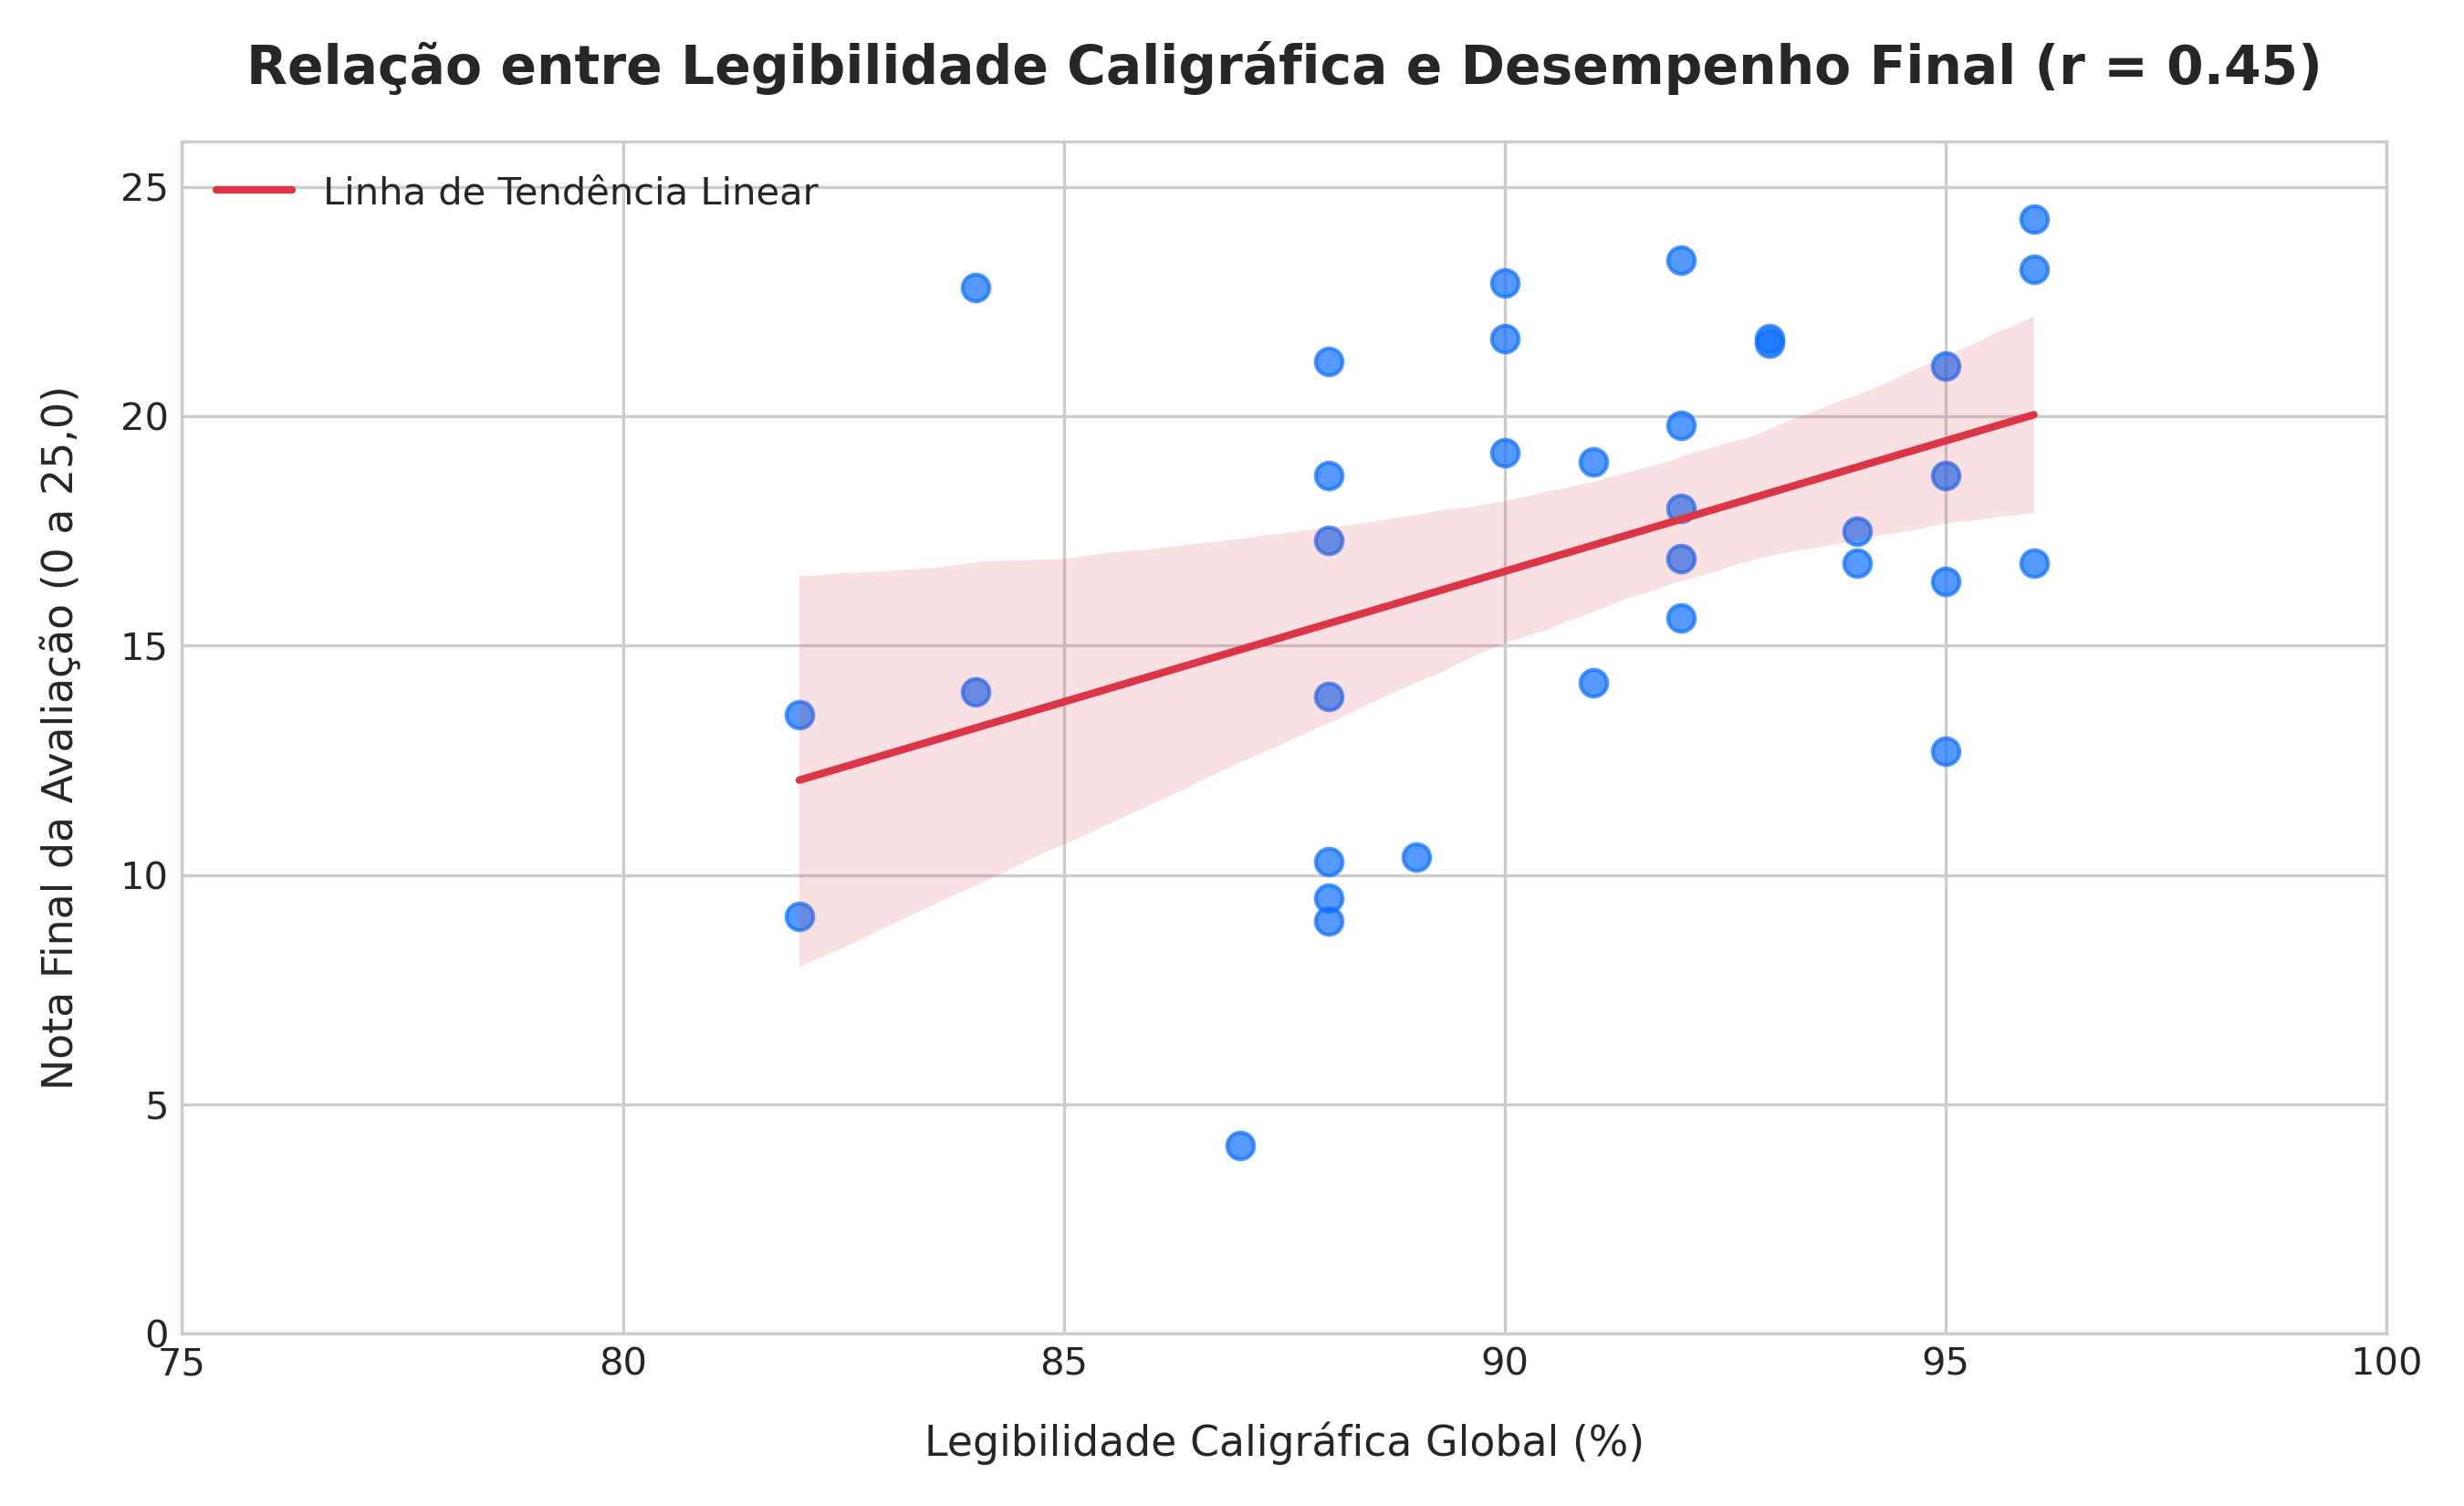
- Caligrafia e organização. Alunos com notas mais altas consistentemente apresentaram caligrafia legível, uso do espaço de rascunho e respostas bem estruturadas, facilitando a correção. O índice de legibilidade médio da turma situou-se em 90,5%, com correlação positiva moderada em relação à nota final.
Pontos de atenção
- Itens em branco concentrados. Os subitens mais deixados sem resposta foram 2.3 (Milestones vs. Sprints), 3.3 (heurística 1:10:100 em IA), 4.3 (modelagem de risco) e 5.3 (Thomas-Kilmann) — todos subitens de 2,0 pontos que exigem raciocínio aplicado, não apenas definição.
- Alunos que confundiram sistematicamente conceitos. Cerca de 4 alunos demonstraram lacunas que atravessam várias questões, como confundir projeto com operação, EAP com lista de tarefas, e Prevenção com Avaliação — são conceitos fundamentais que precisam de recuperação antes da Prova 2.
- EAP é o ponto mais frágil da turma. Mesmo entre alunos com nota acima de 20, a Q2 (EAP e Backlog) teve a menor média. A habilidade de decompor escopo em entregas hierárquicas com a regra dos 100% precisa de mais prática.
- Segurança de IA ainda é superficial. Embora tenha havido boa compreensão de prompt injection, a defesa em profundidade, a modelagem completa de riscos e a mitigação de alucinação foram tratadas de forma genérica — “validar a resposta” ou “usar system prompt” sem detalhamento.
Recomendações para a Turma
Reforçar EAP e decomposição de escopo. A Q2 revelou que a turma sabe listar componentes, mas tem dificuldade em estruturá-los hierarquicamente, nomeá-los como entregas (substantivos, não verbos) e aplicar a regra dos 100%. Recomendo um exercício rápido: decompor o Professor Agente em EAP de três níveis.
Praticar modelagem de riscos completa. Os cinco elementos (causa, probabilidade, impacto, mitigação, contingência) raramente apareceram juntos. Um exercício de preencher uma tabela de riscos para o próprio projeto com os 5 campos pode consolidar isso.
Treinar análise de conflitos com Thomas-Kilmann. A maioria sabe qual abordagem escolher, mas não consegue justificar por que as outras são inadequadas. Um caso prático com justificativa das 5 abordagens resolveria.
Corrigir os 4 erros conceituais mais comuns:
- Projeto ≠ Operação (temporalidade).
- EAP é orientada a entregas (substantivos), não a atividades (verbos).
- Revisão de código = Prevenção; Testes automatizados = Avaliação.
- Heurística 1:10:100 é guia qualitativo, não lei universal.
Para os 4 alunos abaixo de 10 pontos: Recomendo uma conversa individual para diagnosticar se a dificuldade foi com o conteúdo, com o tempo de prova ou com a interpretação dos enunciados. A Q2 inteira em branco e a confusão projeto/operação sugerem necessidade de nivelamento de conceitos fundamentais.